
La demostración de GPT-5.6 Sol en un laboratorio de computación cuántica tiene un detalle que la hace más interesante que una simple prueba de rendimiento: el modelo no se limitó a analizar datos históricos, sino que recibió acceso al software que controla mediciones reales.
El primer hecho es el entorno experimental. Beatriz Yankelevich, estudiante de posgrado del Engineering Quantum Systems Group del MIT, trabaja con qubits superconductores que se enfrían cerca del cero absoluto dentro de refrigeradores de dilución. Una vez fabricado y enfriado el chip, buena parte de la interacción con el hardware ocurre mediante software, lo que permitió conectar Codex al flujo experimental.
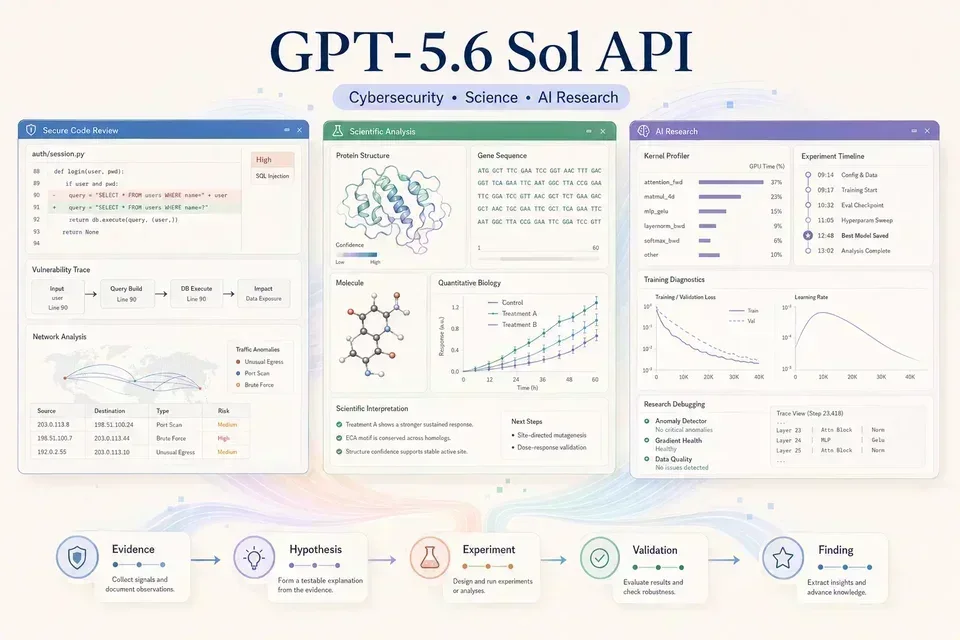
El segundo hecho es el ciclo que pudo automatizar GPT-5.6 Sol. OpenAI explica que el agente podía elegir parámetros de medición, ejecutar pruebas, analizar los resultados y decidir qué intentar después. En un chip de seis qubits sin calibrar, el sistema identificó frecuencias de transición, ajustó pulsos para controlar y leer los qubits y determinó cuánto tiempo conservaban información cuántica.
El tercer punto es el límite que apareció durante la prueba. Cuando las señales eran claras, Codex completó secuencias estándar con poca intervención. Cuando los datos eran débiles o ruidosos, necesitó más tiempo para encontrar parámetros adecuados y en ocasiones requirió guía de una investigadora. OpenAI señala que interpretar resultados físicos ambiguos continúa siendo un desafío para los agentes actuales.
Ese límite cambia la lectura del experimento. No se trata de entregar el laboratorio a una IA y esperar descubrimientos automáticos. La utilidad inmediata está en descargar trabajo repetitivo y mantener mediciones funcionando durante periodos largos. Yankelevich explicó que puede dejar agentes tomando mediciones durante horas, incluso mientras trabaja en otra parte del laboratorio, y revisar después lo ocurrido.
La división del trabajo también resulta reveladora. El agente puede ocuparse de partes bien definidas del ciclo de calibración, mientras la investigadora conserva tareas como interpretar resultados, diseñar experimentos, planear los siguientes pasos y decidir cuándo intervenir. En experimentos novedosos, el margen de autonomía se reduce y la persona proporciona objetivos más estrechos.
La señal de fondo es que los agentes están entrando en una etapa distinta de la investigación científica: ya no sólo generan código o resumen literatura, también pueden interactuar con instrumentos cuando el entorno está suficientemente estructurado. Eso abre una vía para multiplicar horas de medición sin multiplicar de la misma manera la supervisión humana.
Pero el caso también marca el límite actual. La autonomía funciona mejor cuando las reglas de decisión son conocidas y las señales son limpias. Cuando aparece una anomalía física difícil de interpretar, la experiencia humana vuelve a ser el cuello de botella. Para mí, esa frontera es más informativa que cualquier promesa de laboratorio autónomo.
Eso convierte la prueba en un indicador temprano de productividad científica, no en una demostración de independencia completa.